 シェアする
 ポストする
生成AI・RAG向けデータの個人情報マスキングを高精度に自動化する
株式会社Athena Technologiesの「Athena Firewall」を活用し、生成AI活用に向けた安全なデータ整備を検証
生成AIを活用したナレッジ検索・回答支援の高度化に向け、RAG(Retrieval-Augmented Generation、検索拡張生成)で使用するデータに含まれる個人情報を自動的に検出・マスキングするPoCを実施しました。
本PoCでは、株式会社Athena Technologiesが提供する生成AI向けセキュリティ基盤「Athena Firewall」のPII(Personally Identifiable Information、個人を特定できる情報)検知機能を活用しました。
氏名、メールアドレス、電話番号、住所などの一般的な個人情報に加え、業務固有の識別番号にも対応する検出ロジックを構築。実データを用いた検証と、その結果を踏まえたモデル・検出ロジックの改善を繰り返し、マスキング精度の向上を図りました。
PoC実施の背景
RAGを活用したシステムでは、マニュアルやFAQなどの文書に加えて、業務上蓄積されたテキストデータをナレッジとして活用することで、より具体的で実践的な回答を生成できる可能性があります。
一方、業務上蓄積されたテキストデータには、氏名、連絡先、住所、各種識別番号などの個人情報が、さまざまな位置や形式で含まれる場合があります。こうしたデータをRAGで安全に活用するためには、個人情報を適切にマスキングする必要があります。
手動でマスキングする場合には、次のような課題があります。
- 大量のデータを確認するための作業負荷が大きい
- 個人情報の記載位置や表記が一定ではない
- 確認漏れによって個人情報が残るリスクがある
- 新しいデータを追加するたびに確認作業が発生する
- 作業者によって判断にばらつきが生じる可能性がある
そこで、手動マスキング工程の削減と確認漏れの防止に向け、Athena Firewallによる個人情報の自動検出・マスキングの有効性を検証しました。
機械学習とルールを組み合わせた検出方式
業務データに含まれる個人情報は、すべてを同じ方法で検出できるわけではありません。
氏名や住所のように前後の文脈による判断が必要な情報がある一方、桁数や番号体系など、一定の規則を利用して判定できる情報もあります。
また、似た形式の数字列であっても、個人情報としてマスキングすべき情報と、業務上必要な情報とが混在する場合があります。
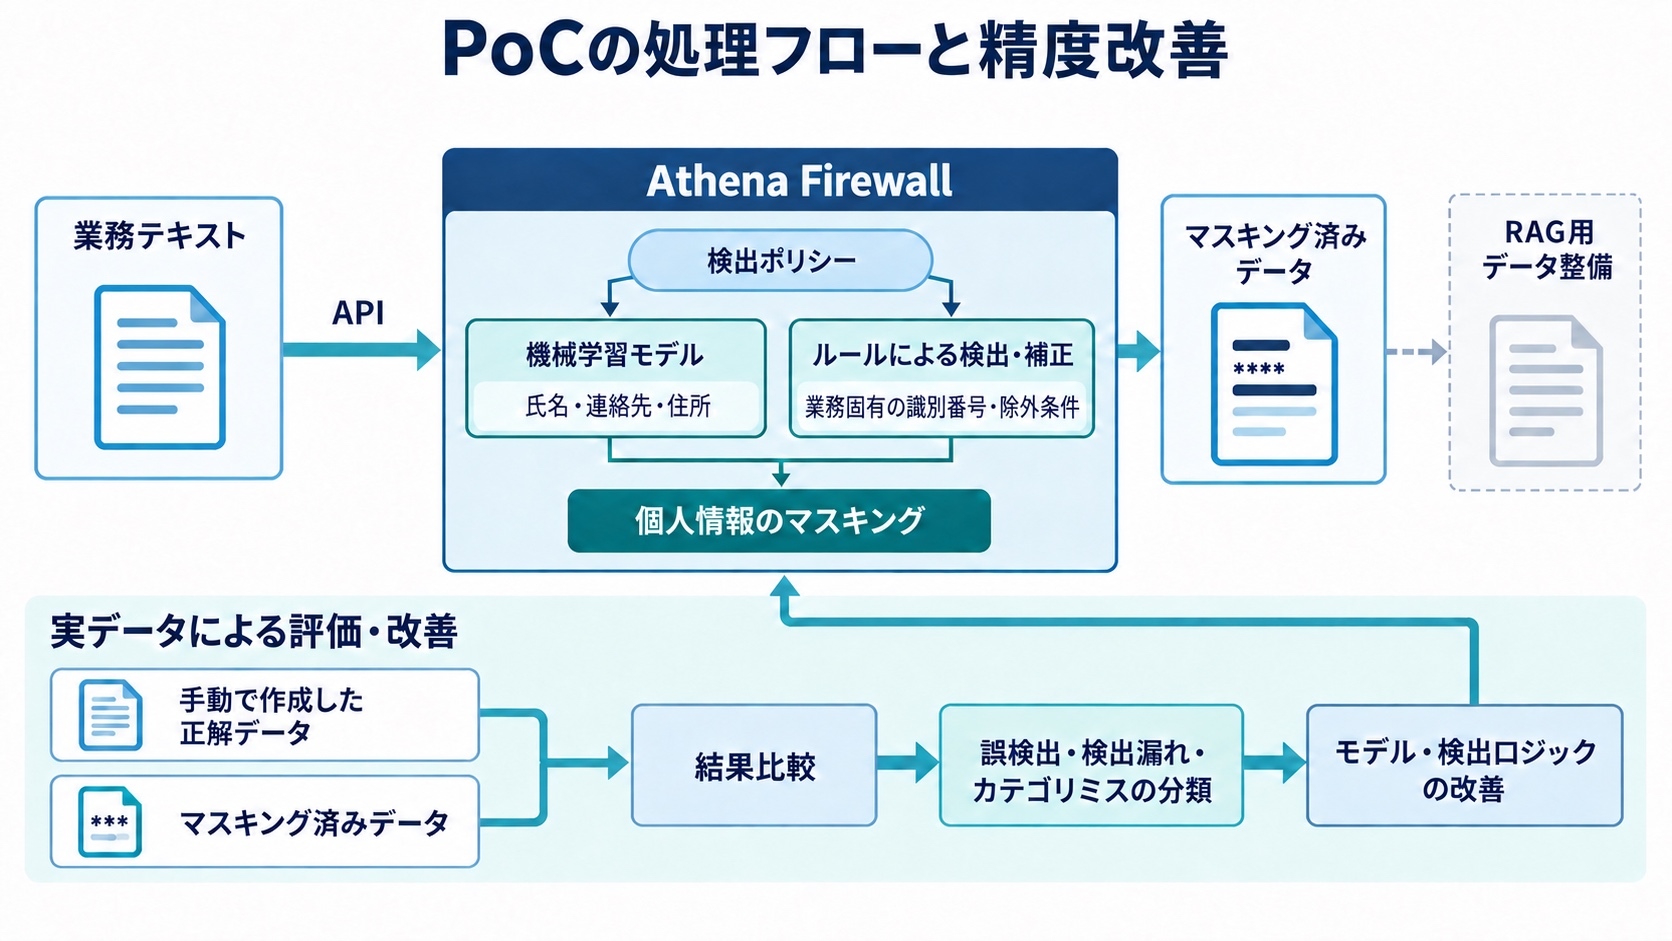
こうしたデータの特性を踏まえ、主に次の2つの方式を組み合わせました。
- 機械学習モデルによる検出
氏名、メールアドレス、電話番号、住所など、前後の文脈を考慮する必要がある情報を検出します。 - ルールによる検出と補正
番号の桁数や形式、周辺のキーワードなどを利用して、業務固有の識別番号を検出します。また、マスキングする必要がない情報を対象から除外する処理にもルールを活用しました。
番号だけでは判別が難しい情報については、周辺に記載された項目名や文章などの文脈と番号形式を組み合わせて判定するなど、実際のデータ特性に合わせて検出方法を調整しました。
実データを用いた反復型の精度改善
精度改善にあたっては、一度の検証で完成を目指すのではなく、実データによる評価と改善を繰り返すアプローチを採用しました。
具体的には、次のサイクルで検証を進めました。
- 手動で正解データを作成
- Athena Firewallでマスキングを実施
- 正解データとマスキング結果を比較
- 誤検出、検出漏れ、カテゴリミスを分類
- モデルや検出ロジックを改善
- 実データを用いて再検証
実データによる評価結果をもとに課題を整理し、株式会社Athena Technologiesが検出モデルやロジックを改善しました。
その結果を再び実データで評価するサイクルを繰り返しました。
初期の検証では、業務上必要な数字列を個人情報として検出するケース、氏名の一部を検出できないケース、形式が類似する識別番号を別のカテゴリとして判定するケースなどが確認されました。これらの課題に対して、次のような改善を実施しました。
確認された課題 | 実施した改善 | 改善の狙い |
|---|---|---|
業務上必要な番号や文字列を個人情報として検出する | 一定の形式を持つ情報を判別し、マスキング対象から除外する処理を追加 | 個人情報ではない情報の過検出を抑制 |
形式が似た識別番号を別のカテゴリとして判定する | 番号形式だけでなく、周辺のキーワードや文章を考慮するロジックへ改善 | 文脈に応じた適切なカテゴリ判定 |
全角・半角、カタカナ、空白の有無などで検出結果が変わる | 表記パターンを拡充し、モデルと検出ロジックを調整 | 表記ゆれによる検出漏れや過検出を抑制 |
長い文章で検出結果にばらつきが生じる | 文章を適切な単位に分割して処理 | 長文データに対する検出結果を安定化 |
複数行にまたがる情報をマスキングすると文書構造が変わる | 改行位置を考慮したマスキング処理を追加 | 元の文書構造を可能な限り維持 |
同じカテゴリのマスクが連続し、処理後の文章が読みにくくなる | 空白などを挟んで連続する同一カテゴリのマスクを統合 | マスキング後の文章の可読性を向上 |
汎用的な機械学習モデルだけに依存するのではなく、実際の業務データに存在する表記やパターンを分析し、モデルとルールを組み合わせることで精度改善を進めました。
段階的な改善でマスキング精度を向上
改善の効果を確認するため、実データによる検証を複数回実施しました。
評価指標 | 初回検証 | 最終検証 |
|---|---|---|
誤検出 | 79% | 4% |
検出漏れ | 57% | 11% |
カテゴリミス | 14% | 3% |
実データから得られたフィードバックをもとに、モデルと検出ロジックを段階的に改善した結果、いずれの評価指標も初回検証から低減しました。
この結果から、実データで発生するエラーを分類し、モデルや検出ロジックへ継続的に反映するアプローチが、マスキング精度の改善に有効であることを確認しました。
注記
上記は本PoCにおける検証結果です。対象データ、評価単位、判定基準、許容条件などによって結果は異なります。また、Athena Firewallがすべての個人情報を常に100%検出することを保証するものではありません。
APIを活用したデータ処理フローもPoCで検証
Athena FirewallのAPIを活用したマスキング処理についても、既存のデータ処理フローとの連携方法を検証しました。
Athena Firewallでは、検出対象となる情報のカテゴリなどをポリシーとして設定し、APIを通じて対象テキストを処理できます。
これにより、対象データの特性や用途に応じて検出対象を制御できます。さらに、個別のテキストを処理するだけでなく、RAG用データを整備する一連の処理に個人情報マスキングを組み込むユースケースについても確認しました。
RAGの品質向上に向けたデータ整備
RAGを活用したシステムでは、大規模言語モデル自体の性能だけでなく、検索対象となるデータの品質も回答精度を左右します。
株式会社Athena Technologiesのこれまでの取り組みでも、入力データのクレンジングや業務用語の整理、プロンプトの改善などを組み合わせ、段階的な精度向上を図るアプローチを採用しています。
RAGで業務データを有効活用するためには、個人情報の除去に加えて、不要データの除外、表記ゆれへの対応、業務用語の整理、検索対象データの構造化など、検索前のデータ整備も重要です。
こうした観点から、実際の業務データをより安全にRAGで活用するための前処理として、Athena Firewallの有効性を検証しました。
Athena Firewallについて
Athena Firewallは、生成AIシステムで取り扱われるデータに含まれるPIIなどの検出を支援するセキュリティ基盤です。
PII検知では、氏名、メールアドレス、電話番号、住所などを機械学習モデルで検出できるほか、ルールによる検出を組み合わせることができます。
本PoCでは、標準的な検出対象に加えて、業務固有の識別番号に対応する検出方法についても確認しました。
また、検出対象をポリシーとして設定し、APIを通じてテキストを処理できます。これにより、既存のシステムやデータ処理フローとの連携が可能です。
株式会社Athena Technologiesについて
株式会社Athena Technologiesは、DXソリューション事業とAIセキュリティ事業を展開しています。
AIセキュリティと、顧客の課題に応じたAI開発・データ分析を組み合わせ、セキュリティ要件の高い環境におけるAI活用を支援しています。
関連する事例
IT戦略・人材育成のご相談
まずはお気軽にお問い合わせください